pdfrag: strukturierte Daten aus medizinischen Berichten
Auftraggeber: Swiss Sarcoma Network. Auftrag über Swiss NTech.
Ausgangslage
Befunde aus Radiologie, Pathologie, Chirurgie und weiteren Bereichen liegen als PDF vor. Für Auswertung und Forschung müssen die relevanten Angaben daraus herausgesucht und in eine strukturierte Form übertragen werden. Das geschieht von Hand, kostet pro Dokument Zeit, und die Dokumente unterscheiden sich je nach Fachbereich stark im Aufbau.
Umsetzung
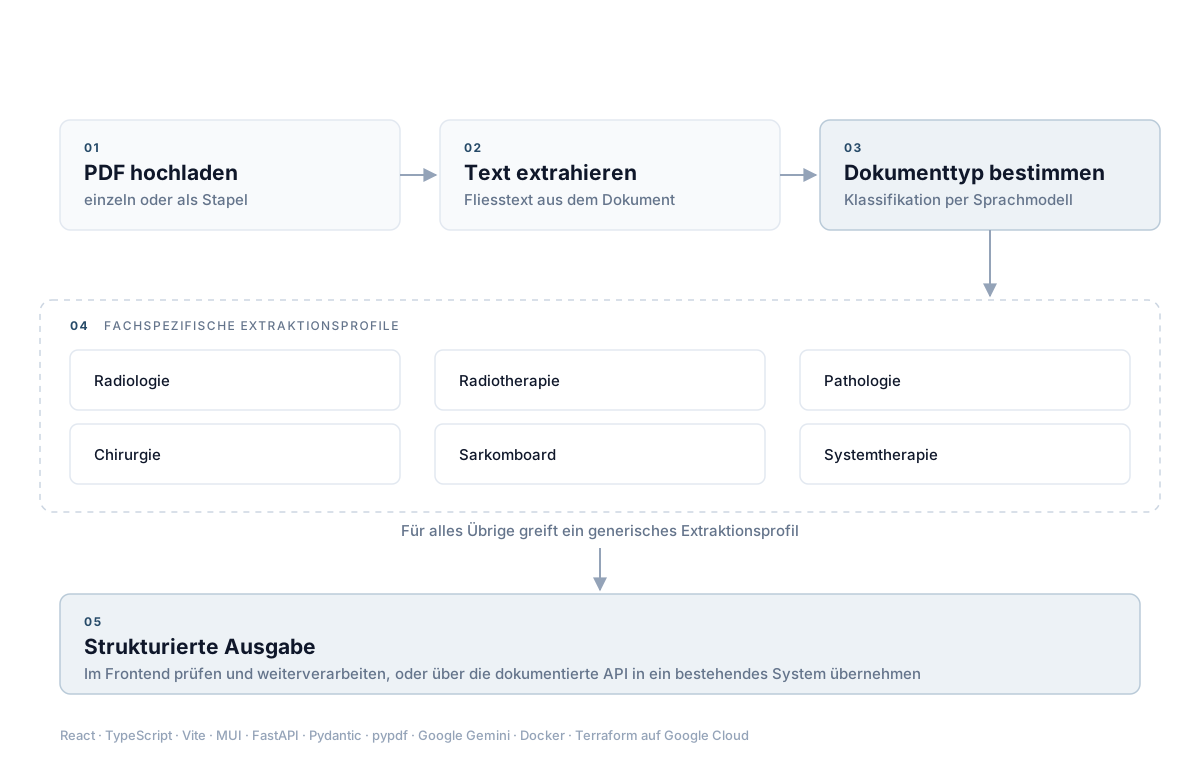
Die Anwendung nimmt PDFs einzeln oder als Stapel entgegen, extrahiert den Text und bestimmt mit einem Sprachmodell zuerst den Dokumenttyp. Danach greift ein eigenes Extraktionsprofil pro Fachbereich, mit getrennten Schemata für Radiologie, Radiotherapie, Pathologie, Chirurgie, Sarkomboard und Systemtherapie. Ein generisches Profil deckt alles Übrige ab. Die Ergebnisse lassen sich im Frontend prüfen und weiterverarbeiten, und die Funktionen stehen zusätzlich als dokumentierte API zur Verfügung, damit sie sich in bestehende Systeme einbinden lassen.
Technik
React, TypeScript, Vite und MUI im Frontend. FastAPI mit Pydantic und pypdf im Backend, Google Gemini als Sprachmodell. Betrieb über Docker Compose hinter einem Nginx-Reverse-Proxy, Infrastruktur auf Google Cloud als Terraform-Code. Hochgeladene Dateien liegen nur temporär und werden automatisch aufgeräumt, die Schnittstellen sind ratenbegrenzt, Zugangsdaten laufen ausschliesslich über Umgebungsvariablen.
Stand
Lauffähiger Prototyp mit durchgängigem Ablauf von Upload über Extraktion bis zur strukturierten Ausgabe, mit Tests für Backend und Frontend. MVP und Proof of Concept, nicht im produktiven Einsatz.